
Mục lụcChạm để xem nhanh các phần+
- 01Vì sao PDF mở được nhưng không lấy được số liệu
- 02Chuẩn bị tệp trước khi OCR
- 03Ba lớp xử lý: nhận dạng, chuẩn hóa và kiểm tra
- 04Giữ dấu vết về trang nguồn quan trọng hơn một bảng đẹp
- 05Đừng dùng cùng một mẫu cho ngân hàng và doanh nghiệp thông thường
- 06Quy trình kiểm tra kết quả trong mười phút
- 07Khi nào nên xây một pipeline Document AI riêng
- 08Checklist trước khi dùng số liệu OCR
- OCR chỉ tạo bản dữ liệu làm việc; tài liệu công bố chính thức vẫn là nguồn phải đối chiếu.
- Số trang, vùng nhận dạng, đơn vị và điểm tin cậy cần đi cùng mỗi chỉ tiêu để người đọc sửa được sai số.
- Các phép kiểm tra như tài sản bằng nợ phải trả cộng vốn chủ sở hữu giúp phát hiện lỗi, nhưng không chứng minh mọi con số đều đúng.
Vì sao PDF mở được nhưng không lấy được số liệu
Nhiều báo cáo tài chính là tập ảnh được đóng trong một tệp PDF. Người đọc vẫn nhìn thấy chữ và bảng, nhưng máy tính không có lớp văn bản để tìm kiếm hoặc sao chép. Một số tệp khác có lớp chữ nhưng bị lệch cột, mất dấu chấm phân cách hoặc đảo thứ tự khi dán sang bảng tính.
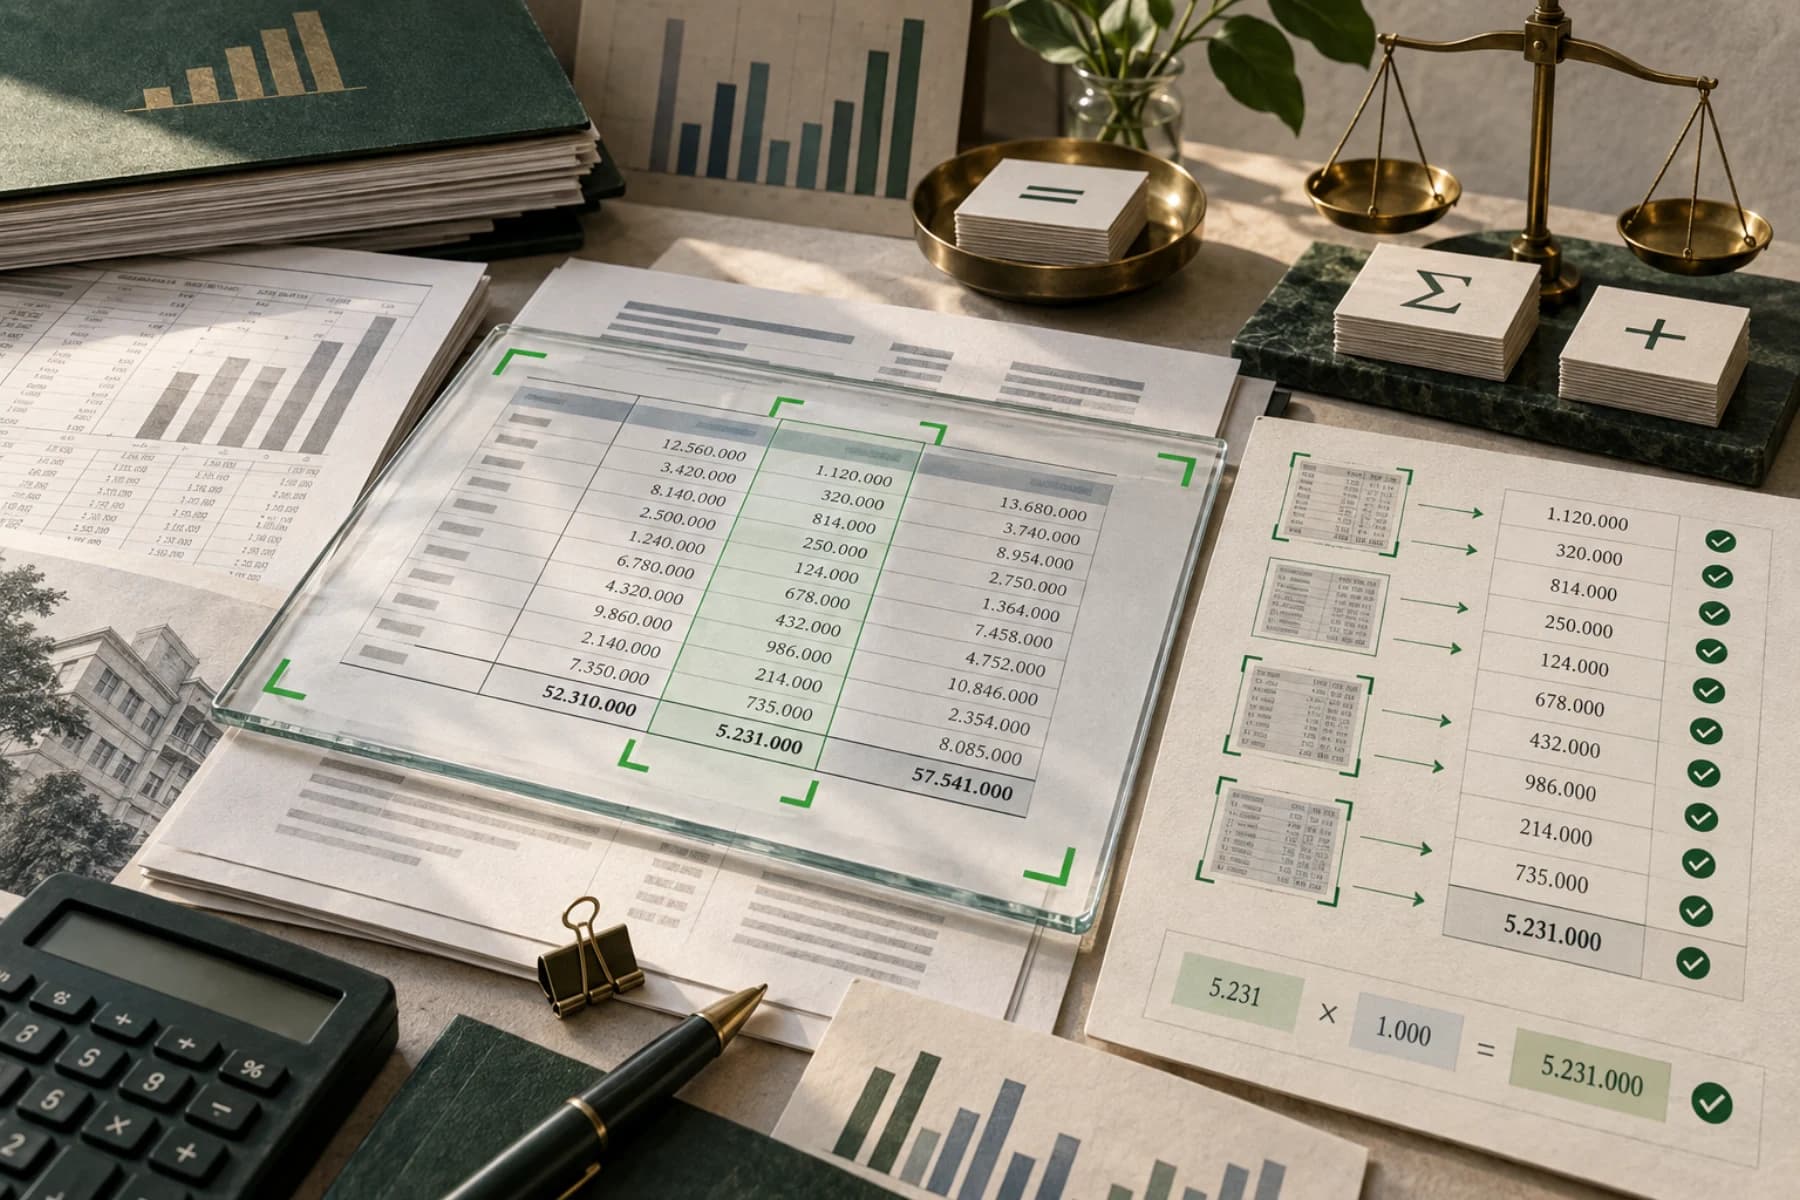
OCR, tức nhận dạng ký tự quang học, biến hình ảnh chữ và số thành dữ liệu máy có thể đọc. Với báo cáo tài chính, nhận đúng ký tự mới chỉ là bước đầu. Hệ thống còn phải tìm bảng, hiểu cột kỳ hiện tại và kỳ so sánh, nhận đơn vị, giữ số trang và kiểm tra quan hệ giữa các chỉ tiêu.
Công cụ của Friday Works tập trung vào báo cáo tài chính tiếng Việt, tách riêng mẫu doanh nghiệp thông thường và ngân hàng. Kết quả dùng để hỗ trợ rà soát; không thay thế báo cáo công bố chính thức.
Giá trị của OCR không nằm ở việc bỏ qua tài liệu gốc, mà ở việc đưa người kiểm tra đến đúng trang và đúng con số nhanh hơn.
Chuẩn bị tệp trước khi OCR
Một bản scan thẳng, đủ sáng và còn nguyên trang luôn dễ xử lý hơn ảnh chụp xiên hoặc bản bị nén nhiều lần. Trước khi tải lên, hãy mở vài trang đầu, một trang bảng cân đối và một trang thuyết minh để kiểm tra chiều trang, độ nét và việc có bị cắt mép hay không.
Nếu có nhiều phiên bản, ưu tiên bản từ cổng công bố của doanh nghiệp hoặc sở giao dịch. Đổi tên tệp bằng mã doanh nghiệp, kỳ báo cáo và loại báo cáo để tránh dùng nhầm. Không chỉnh sửa số trên bản gốc; nếu phải xoay hoặc tách trang, giữ lại tệp ban đầu để đối chiếu.
Chỉ tải lên tài liệu bạn có quyền xử lý. Với báo cáo công khai, nên lưu đường dẫn nguồn và ngày tải. Với tài liệu nội bộ, cần xem lại chính sách dữ liệu trước khi dùng bất kỳ dịch vụ trực tuyến nào.
- Trang không nghiêng, không bị cắt số thứ tự hoặc phần đơn vị.
- Độ phân giải đủ để phân biệt 0, 6, 8 và dấu âm trong ngoặc.
- Đúng kỳ báo cáo, đúng bản hợp nhất hoặc riêng lẻ cần phân tích.
- Tên tệp và ghi chú nguồn giúp truy lại tài liệu sau khi xuất dữ liệu.
Ba lớp xử lý: nhận dạng, chuẩn hóa và kiểm tra
Lớp nhận dạng xác định trang nào là bảng cân đối, kết quả kinh doanh hoặc lưu chuyển tiền tệ, rồi lấy nhãn và số theo từng dòng. Tesseract, một dự án OCR mã nguồn mở phổ biến, lưu ý rằng PDF cần được chuyển sang định dạng ảnh phù hợp hoặc xử lý qua công cụ chuyên cho PDF trước khi nhận dạng. Điều này cho thấy OCR không chỉ là đưa nguyên tệp vào một hàm rồi chờ kết quả.
Lớp chuẩn hóa giải quyết đơn vị và định dạng. Báo cáo có thể trình bày theo đồng, nghìn đồng hoặc triệu đồng; dấu chấm có thể là dấu phân cách hàng nghìn. Hệ thống phải giữ cả giá trị thô và giá trị đã quy đổi để người đọc thấy quá trình biến đổi.
Lớp kiểm tra đối chiếu các quan hệ có thể kiểm tra tự động. Ví dụ, tổng tài sản cần gần bằng nợ phải trả cộng vốn chủ sở hữu trong cùng kỳ. Nếu chênh lệch lớn, nguyên nhân có thể là nhận sai chữ số, sai đơn vị, chọn nhầm cột hoặc thiếu dòng; kết quả phải được đưa về trạng thái cần người xem lại.
Giữ dấu vết về trang nguồn quan trọng hơn một bảng đẹp
Một bảng trích xuất trông ngay ngắn vẫn có thể sai. Vì vậy, mỗi chỉ tiêu nên đi kèm số trang, đoạn chữ nguồn, vùng nhận dạng và điểm tin cậy. Khi thấy doanh thu hoặc tổng tài sản bất thường, người dùng có thể quay đúng trang thay vì dò lại cả báo cáo.
Điểm tin cậy thấp không nhất thiết đồng nghĩa số sai, nhưng là dấu hiệu nên kiểm tra trước. Ngược lại, điểm cao cũng không bảo đảm đúng nếu hệ thống đã chọn nhầm cột. Cần kết hợp tín hiệu nhận dạng với quy tắc kế toán và việc đọc lại tài liệu.
Khi xuất CSV hoặc JSON, đừng bỏ các trường nguồn chỉ để bảng gọn hơn. Những trường này là bằng chứng giúp sửa lỗi và giải thích dữ liệu về sau.
- Giá trị gốc đúng như trên trang và giá trị đã chuẩn hóa.
- Đơn vị trình bày của báo cáo.
- Trang, loại báo cáo và kỳ hiện tại hoặc kỳ so sánh.
- Điểm nhận dạng và trạng thái cần kiểm tra thủ công.
Đừng dùng cùng một mẫu cho ngân hàng và doanh nghiệp thông thường
Bảng cân đối của ngân hàng có cấu trúc khác doanh nghiệp sản xuất hoặc thương mại. Tên dòng, cách trình bày tài sản và nợ, cùng những chỉ tiêu quan trọng không giống nhau. Nếu ép mọi tài liệu vào một schema, hệ thống có thể gắn đúng con số vào sai ý nghĩa.
Bước nhận diện mẫu nên diễn ra trước khi trích chỉ tiêu. Khi không chắc, kết quả cần ghi rõ trạng thái cần xem lại thay vì tự đoán. Với các ngành có biểu mẫu riêng, nên thử trên nhiều báo cáo và nhiều chất lượng scan trước khi dùng ở quy mô lớn.
Document AI đi xa hơn OCR ở chỗ phân loại tài liệu, hiểu cấu trúc, trích trường và áp quy tắc kiểm tra. Tuy nhiên, quy trình tốt vẫn cần một tập mẫu đại diện và tiêu chí lỗi rõ ràng; không có mô hình nào tự giải quyết mọi kiểu tài liệu.
Quy trình kiểm tra kết quả trong mười phút
Bắt đầu bằng hồ sơ tệp: số trang, tỷ lệ trang có lớp chữ, chiều trang và schema được nhận diện. Nếu số trang không khớp hoặc nhiều trang bị xoay, dừng lại trước khi tin vào bảng kết quả.
Tiếp theo, chọn các chỉ tiêu neo như tổng tài sản, doanh thu thuần, lợi nhuận sau thuế và tiền cuối kỳ. Mở trang nguồn, so cả kỳ hiện tại và kỳ so sánh, kiểm tra dấu âm và đơn vị. Đây là cách nhanh để phát hiện việc lệch cột hoặc nhân sai hệ số.
Cuối cùng, xem các phép kiểm tra cân đối và mọi dòng có điểm tin cậy thấp. Nếu một dòng sai, sửa trong bảng làm việc nhưng giữ giá trị OCR ban đầu và ghi chú lý do. Dữ liệu đã sửa phải có người, thời điểm và nguồn đi kèm nếu được đưa vào quy trình doanh nghiệp.
- Xác nhận số trang, hướng trang và loại mẫu.
- Đối chiếu ít nhất bốn chỉ tiêu neo ở cả hai kỳ.
- Kiểm tra đơn vị và dấu âm trước khi so sánh.
- Xem phương trình kế toán và các dòng cần người duyệt.
- Chỉ xuất sang hệ thống khác sau khi đã chốt trạng thái kiểm tra.
Khi nào nên xây một pipeline Document AI riêng
Công cụ miễn phí phù hợp để đọc nhanh một báo cáo hoặc đánh giá chất lượng tệp. Nếu doanh nghiệp phải xử lý nhiều tài liệu, nhiều mẫu và đẩy kết quả vào phần mềm kế toán, CRM hoặc kho dữ liệu, cần một pipeline có hàng đợi, lưu trạng thái, quyền truy cập và màn hình duyệt.
Hãy đo chất lượng theo từng trường thay vì một tỷ lệ chính xác chung. Sai mã số thuế, ngày hoặc tổng tiền có hậu quả khác với sai một dòng mô tả. Trường quan trọng nên có ngưỡng tin cậy riêng và được chuyển cho người duyệt khi không đạt.
Bắt đầu bằng một nhóm mẫu đại diện, kể cả scan xấu và biểu mẫu hiếm. Sau pilot, doanh nghiệp mới có đủ dữ liệu để ước lượng tỷ lệ phải duyệt, chi phí mỗi tài liệu và phần nào nên tự động hoàn toàn.
Checklist trước khi dùng số liệu OCR
Không dùng số liệu chỉ vì bảng đã xuất được sang Excel. Một kết quả đủ tin cậy phải giúp bạn trả lời các câu dưới đây và quay lại đúng tài liệu khi có tranh luận.
- Tệp có phải bản công bố chính thức và đúng kỳ không?
- Schema doanh nghiệp hoặc ngân hàng đã được nhận đúng chưa?
- Đơn vị đồng, nghìn đồng hay triệu đồng có được giữ và quy đổi đúng không?
- Mỗi chỉ tiêu quan trọng có trang nguồn và giá trị thô không?
- Các phép kiểm tra cân đối có qua không; nếu không, chênh lệch đến từ đâu?
- Ai đã duyệt dữ liệu trước khi xuất sang báo cáo hoặc hệ thống khác?
FAQ
Câu hỏi thường gặp
OCR có đọc được báo cáo tài chính PDF scan không có lớp chữ không?
Có. Công cụ nhận dạng chữ và số từ ảnh trang, sau đó tách các chỉ tiêu chính. Chất lượng vẫn phụ thuộc độ nét, độ nghiêng, mẫu báo cáo và cần được đối chiếu với trang nguồn.
Số liệu OCR có thể dùng ngay để phân tích hoặc giao dịch không?
Không nên dùng khi chưa kiểm tra. Hãy đối chiếu chỉ tiêu quan trọng, đơn vị, kỳ báo cáo và các phép cân đối với tài liệu công bố chính thức.
Công cụ có phân biệt báo cáo ngân hàng và doanh nghiệp không?
Có. Hai nhóm dùng schema riêng vì cấu trúc bảng và ý nghĩa chỉ tiêu khác nhau. Trường hợp không chắc chắn cần được đánh dấu để người dùng xem lại.
File tải lên được lưu trong bao lâu?
PDF được lưu tạm trong thời gian OCR rồi bị xóa. Kết quả được trả về trình duyệt và có thể tải xuống để đối chiếu.
Nguồn tham khảo
Tài liệu đã dùng để biên soạn
Ưu tiên tài liệu chính thức và nguồn kỹ thuật gốc. Truy cập để kiểm tra chi tiết hoặc theo dõi cập nhật mới nhất.
- Input formatsTesseract OCR Documentation ↗︎
- Processor listGoogle Cloud Document AI ↗︎
- Layout parser and document chunkingGoogle Cloud Document AI ↗︎
- Số hóa tài liệu tự động bằng trí tuệ nhân tạo và mô hình ngôn ngữ lớnVnExpress AI4VN 2026 ↗︎
- AI lõi Make in Vietnam được xếp hạng thứ 12 thế giớiBáo Đầu tư ↗︎